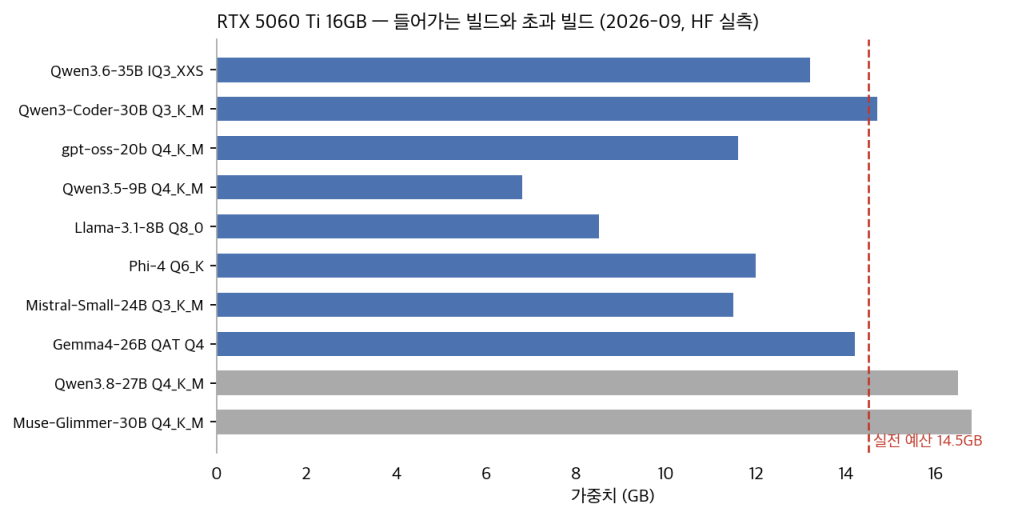
5060 Ti 16GB는 2026년 로컬 LLM 시장의 최저가 16GB 카드입니다. Windows 기준 OS+드라이버가 약 1GB를 먹으니 가중치 예산은 실전 13~14.5GB (KV를 q4_0으로 줄이고 컨텍스트를 줄이는 조건). 아래 표의 크기는 전부 Hugging Face 라이브 파일에서 오늘 실측한 값입니다.
| 모델 | 빌드 | 가중치 | 속도 | 출처/비고 |
|---|---|---|---|---|
| Qwen3.6-35B-A3B | IQ3_XXS | 13.2 GB | 47~51 tok/s (160K 컨텍스트 실측) | njannasch.dev 실측 — KV q4_0 962MiB 포함 15,847MiB 사용 |
| Qwen3-Coder-30B-A3B | Q3_K_M | 14.7 GB | 30B급 1위 권고 | r/LocalLLaMA 5060 Ti 스레드 — ’30B still wins’ |
| gpt-oss-20b | Q4_K_M | 11.6 GB | 5080에서 242.8 tok/s (upstream GGUF) | techfuelhq 실측 — 5060 Ti는 이보다 낮음 |
| Qwen3.5-9B | Q4_K_M | 6.8 GB | 예상 40~51 tok/s | modelfit.io 8B급 51 tok/s 추정 병기 |
| Llama-3.1-8B | Q8_0 | 8.5 GB | 예상 ~50 tok/s | modelfit.io — 8B급 51 tok/s |
| Phi-4 | Q6_K | 12.0 GB | 예상 ~30 tok/s | modelfit.io 14B Q4 32 tok/s 대비 한 단계 위 비트 |
| DeepSeek-R1-Distill-8B | Q4_K_M | 4.9 GB | 예상 45~55 tok/s | 8B dense 기준 |
| Mistral-Small-3.2-24B | Q3_K_M | 11.5 GB | 미측정 | KV 포함 14GB선 — 애매하게 들어감 |
| Gemma 4 26B-A4B QAT | UD-Q4_K_XL | 14.2 GB | 미측정 — 가장 유력한 신규 | QAT라 4비트 품질 최상 — KV q8 필수 |
안 들어가는 것들
- Qwen3.8-27B Q4_K_M 16.5GB — 가중치만으로도 초과. 두 장(5060 Ti ×2)이면 130 tok/s 실측 보고가 있습니다 (r/LocalLLaMA).
- Muse-Glimmer-30B Q4_K_M 16.8GB, Laguna-XS-2.1 Q4_K_M 19.6GB — 24GB 카드 영역.
- dense 30B 이상 — MoE(A3B급)만 현실적입니다.
런타임 선택
같은 카드 공개 실측: llama.cpp 77.0 / LM Studio 76.8 / Ollama 69.1 tok/s (Qwen2.5-Coder-7B Q4, inventivehq). GUI면 LM Studio, API 서비스면 Ollama인데 Ollama는 컨텍스트 슬라이더 기본값 함정이 있습니다 — 런타임 3종 비교 참고. 배치·KV 설정 하나 차이가 모델 교체보다 큽니다.
더 긴 레시피 목록은 커뮤니티 축적 리포 club-5060ti에 있습니다. 노트북 5060 Ti(TGP 낮은 쪽)는 노트북 GPU TGP 가이드를 먼저 보세요. VRAM 계산 공식은 VRAM 사용처별 가이드.
2026-09-28 작성 · 파일 크기는 Hugging Face 라이브 목록 실측, 속도는 출처 명시된 공개 측정과 제 실측만 사용 · 로컬 실행 없음 · 전체 허브 보기 · 양자화 사다리 104빌드 · 47종 생성 속도 차트


댓글 남기기